
Ученые провели исследование, чтобы понять, как нейронные сети мозга обрабатывают смысловую нагрузку устной речи. В работе, опубликованной в журнале Nature Neuroscience, авторы отталкивались от принципов работы больших языковых моделей (LLM), лежащих в основе современных чат-ботов.
Исследование, основанное на модели LLM, показало, как клетки мозга кодируют значение слов
Исследователи применили модели ИИ, чтобы выяснить, как мозг человека распознает смыслы слов в контексте. Ученые проанализировали активность отдельных клеток гиппокампа у участников, слушали аудиозаписи рассказов. Выяснилось, что значения кодируются не отдельными нейронами, а распределенными паттернами, которые активируются вместе.
Гиппокамп. https://www.livescience.com/hippocampus
Как «прослушивают» нейроны. Запись активности отдельных нейронов человеческого мозга — крайне редкая и сложная процедура. Ученые смогли собрать уникальные данные благодаря участию пациентов с эпилепсией. Им вживляли тончайшие проволочные электроды в области гиппокампа в рамках клинического мониторинга перед операцией. Это позволило исследователям совместить медицинскую диагностику с научным поиском на стыке нейробиологии и ИИ.
В эксперименте приняли участие десять человек с вживленными по медицинским показаниям микроэлектродами. Пока пациенты слушали аудиорассказы, специалисты фиксировали активность одиночных нейронов в гиппокампе — области мозга, ключевой для памяти и восприятия.
Анализ активности нейронов с применением математического кодирования показал, что реакция клеток отражает именно семантику слов, даже после исключения влияния фонематических и грамматических факторов. Смысловое значение не закреплено за одной клеткой: отдельное слово вызывает сложный ответ всей группы нейронов.
Сложные смысловые связи и контекст
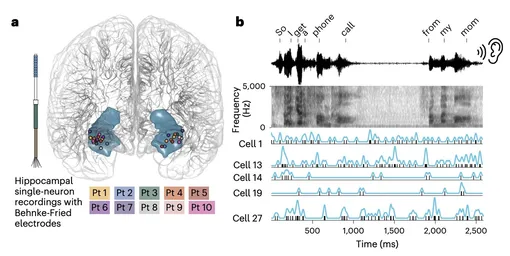
Нейроны гиппокампа отслеживают произносимые слова в процессе понимания речи. а) Расположение электродов для регистрации активности нейронов гиппокампа у 10 пациентов (обозначенных как «Pt»). б) Непрерывная импульсная активность пяти типичных нейронов гиппокампа пациента № 6 во время прослушивания слов в ходе эксперимента, как показано на спектрограмме.
Продолжение ниже
Видео
Продолжение
Сравнив нейронные реакции с математическими векторами языковых моделей, авторы обнаружили четкое соответствие. Расстояние между паттернами активности групп клеток коррелирует с семантическим расстоянием между понятиями, определяемым по метрике LLM. При этом ближайшее совпадение нейронной активности зафиксировано с векторными представлениями модели GPT-2.
Исследование также показало, что колебания в структуре реакций клеток напрямую связаны с многозначностью слов, определяемой алгоритмами ИИ. Это подтверждает, что кодирование смысла в гиппокампе носит выраженный контекстуальный характер.
Как отметили авторы работы: «Записывая ответы нейронов гиппокампа во время прослушивания повествовательной речи, с помощью модели кодирования мы обнаружили надежное кодирование семантики. Отдельные слова обладали сложной избирательностью, включавшей множество слов из нескольких семантических категорий». Работа дает вычислительное объяснение того, как мозг интерпретирует контекст.
Загружаем